L’avocate est testée, sa secrétaire presque pas
Dans un cabinet d’avocats, deux personnes travaillent porte à porte. Le travail de l’avocate est passé au crible par des centaines de questions qui servent à noter les IA. Celui de sa secrétaire juridique, qui prépare les actes, classe les pièces et tient l’agenda des audiences, ne l’est presque pas.
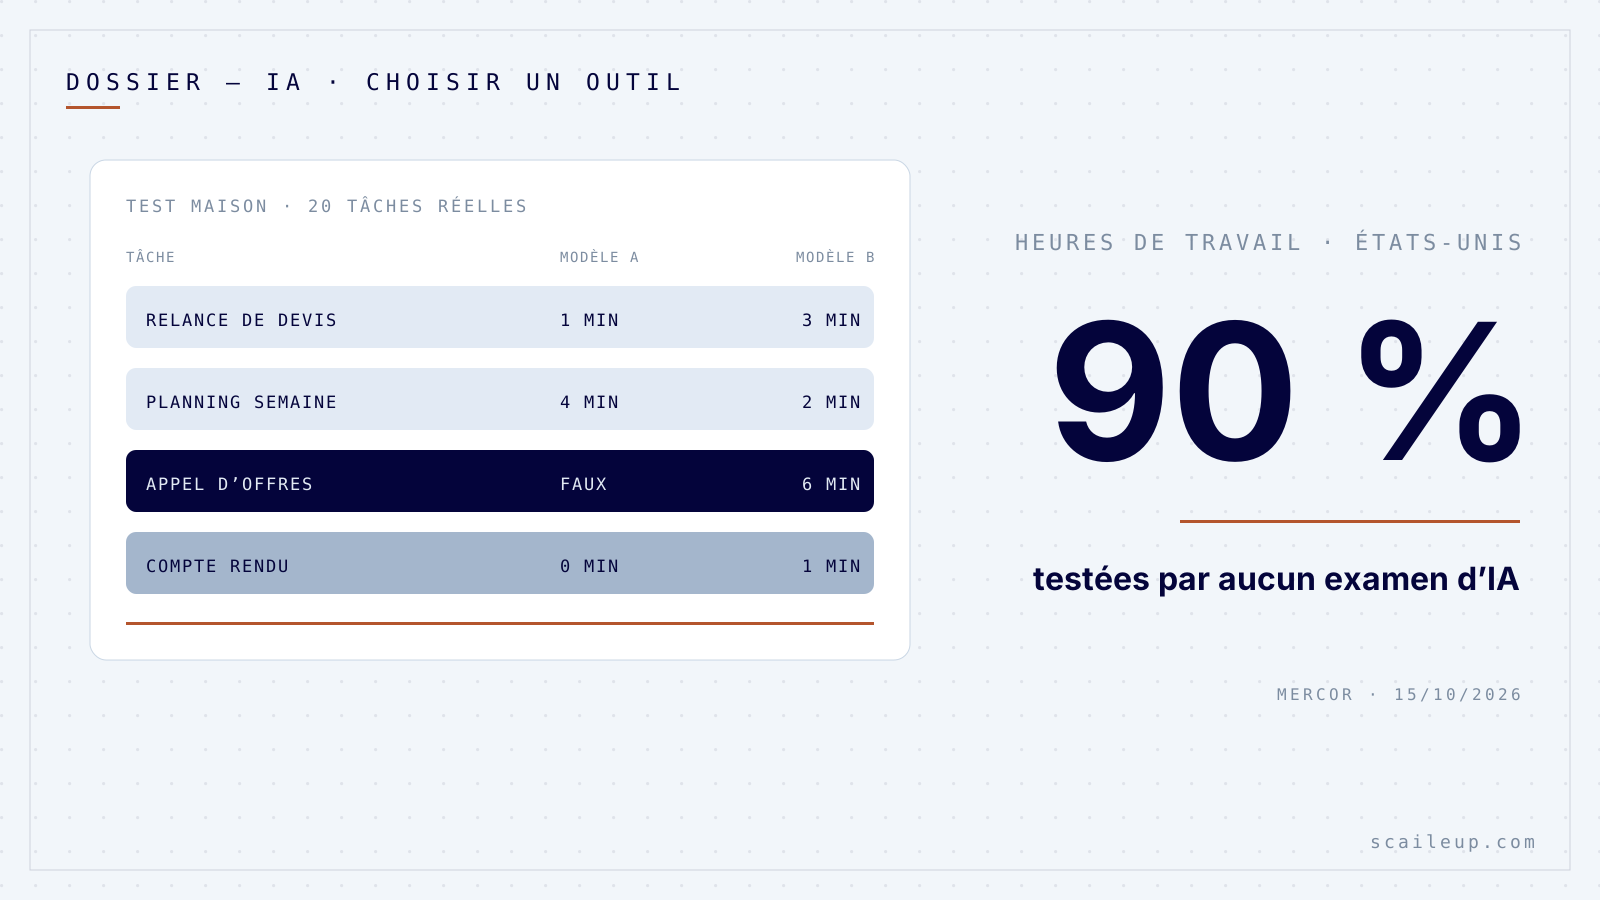
Ce n’est pas une image : c’est l’un des exemples d’une étude publiée le 15 octobre 2026 par Mercor, une entreprise américaine qui fournit des experts aux laboratoires d’IA. Elle a rapproché 29 examens d’IA parmi les plus cités des 18 797 tâches recensées par le ministère du Travail américain. Résultat : environ 90 % des heures de travail portent sur des tâches que ces examens couvrent mal ou pas du tout. L’étude a dépassé 610 votes et 570 commentaires sur Hacker News le lendemain.
Ma thèse, et vous pouvez la contester : quand un éditeur vous dit que son IA est la meilleure, il parle d’un examen que votre métier n’a probablement jamais passé. Le seul classement qui compte pour vous est celui que vous faites vous-même, avec vingt de vos vraies tâches, en une après-midi.
Ce que montre la carte de Mercor
La méthode est simple à suivre. Une IA lit chaque question des 29 examens et la range dans une ou plusieurs tâches de la nomenclature officielle des métiers. Une tâche est dite couverte quand au moins cinq questions la testent. Mercor pèse ensuite chaque tâche par le nombre d’heures que les salariés y passent.
Sur 18 797 tâches, 924 sont couvertes. Sur 923 métiers, 208 ont au moins une tâche testée. Six familles de métiers sur 22 n’en ont aucune. Les écarts entre familles disent tout : 29 métiers couverts sur 36 en informatique, 33 sur 48 en affaires et finance, mais 12 sur 89 dans la santé et 6 sur 22 dans le commercial.
Le biais a une explication. Les examens testent ce qui se corrige facilement et ce qui rapporte gros aux laboratoires : écrire du code, analyser un bilan, répondre à une question de droit. Mercor calcule que les tâches les plus importantes d’un métier sont 6 à 10 fois plus souvent testées que les autres. Or une journée de travail est faite en grande partie des autres : relancer, reformuler, vérifier, planifier.
Pourquoi ça vous concerne, même si vous ne lisez jamais un score
Ces scores ne restent pas dans les laboratoires. Le 28 septembre, Anthropic annonçait Claude Sonnet 5.5 à 1 844 points sur un examen de tâches professionnelles, contre 1 846 pour Opus 5.5. Le 30 septembre, Google mettait en avant 77,9 % pour Gemini 4 Argon sur un examen de programmation. Le 6 octobre, Mistral affichait 61,7 % sur ce même examen. Trois semaines plus tard, ces chiffres sont dans les présentations des revendeurs qui frappent à votre porte.
Posez-vous la question franchement : la réponse à un appel d’offres, la relance d’un client qui a laissé un devis sans réponse, le planning de vos techniciens pour la semaine, le compte rendu d’intervention envoyé au syndic. Aucune de ces tâches n’est dans les examens. Le score ne vous dit pas que l’IA les fait mal. Il ne vous dit rien du tout.
Je dois être honnête sur la source. Mercor vend des données d’experts et des évaluations aux laboratoires : l’écart qu’il mesure est aussi son marché. Et l’étude se dit elle-même provisoire, faute d’avoir regardé tous les examens existants. Je la prends au sérieux quand même, parce que la conclusion ne dépend pas de la précision du chiffre. À 70 % au lieu de 90 %, votre métier reste très probablement hors du champ.
Le test maison : vingt tâches, une après-midi
Voici la grille que j’utilise avant de recommander un outil. Elle tient dans un tableur, en six colonnes. Copiez-la telle quelle :
- Colonne 1, la tâche : copiée d’un vrai message ou d’un vrai document de la semaine dernière, noms et montants des clients retirés. Prenez cinq types de tâches, quatre exemples de chaque, soit vingt lignes.
- Colonne 2, la bonne réponse : celle que vous avez réellement envoyée, ou celle que vous auriez voulu envoyer.
- Colonne 3, la réponse du modèle A, obtenue avec une consigne identique pour tous.
- Colonne 4, la réponse du modèle B, avec la même consigne, mot pour mot.
- Colonne 5, les minutes de correction : combien de temps il faut pour rendre la réponse envoyable. C’est le seul chiffre qui compte.
- Colonne 6, le verdict : envoyable tel quel, à corriger, ou faux. Une réponse fausse qui a l’air juste compte double, parce qu’elle passe.
Ce que ça coûte, et le critère qui tranche
Pour comparer plusieurs modèles sans prendre trois abonnements, OpenRouter donne accès à des dizaines d’IA depuis un seul compte, payé à l’usage, au prix des fournisseurs plus des frais à l’achat de crédits. Les prix publics sont connus : 2 dollars par million de tokens lus, le token étant l’unité de texte que facturent les IA, et 10 dollars par million écrits pour Claude Sonnet 5.5, 4 et 20 dollars pour Opus 5.5, 1,36 et 4,18 dollars pour Mistral Large 4.
Le calcul, pour vingt tâches d’environ 3 000 tokens lus et 1 000 écrits : 0,64 dollar pour Opus 5.5, 0,32 dollar pour Sonnet 5.5, 0,17 dollar pour Mistral Large 4. Moins de deux dollars pour les trois. Le vrai coût est votre temps : trois heures, relecture comprise.
Et le critère qui tranche n’est pas le prix. Si vous envoyez 200 relances par mois et qu’un modèle demande une minute de correction quand l’autre en demande trois, l’écart est de 400 minutes, soit 6 h 40 de travail par mois. Aucune différence de tarif entre ces modèles n’approche ce montant pour une petite équipe. Choisissez le modèle qui vous fait corriger le moins, sur vos tâches, pas celui qui gagne l’examen des autres.
Une précaution : faites relire les réponses par quelqu’un qui ne sait pas quel modèle a écrit quoi. Sans ça, on corrige plus vite la réponse de l’outil qu’on préfère déjà.
Le geste pour lundi matin
Lundi, ouvrez vos messages envoyés et copiez-en cinq de la semaine dernière, sans les noms. Donnez-les à deux IA avec la même consigne, puis chronométrez la correction de chaque réponse. Si l’écart dépasse une minute par message, vous tenez votre critère de choix, et il vaut mieux que n’importe quel classement.
Si vous voulez qu’on construise cette grille sur vos tâches et qu’on choisisse l’outil avec vous, c’est le genre de point que je traite en audit.
Ce sujet vous concerne directement ?
30 minutes d'audit gratuit pour voir ce que ça donnerait dans votre entreprise, chiffres à l'appui.
À lire ensuite
Automatisation et IA · 6 min
Une IA française ne protégera pas vos données si vos salariés collent vos devis dans un compte gratuit : ce que Mistral Large 4 change vraiment pour une PME
Automatisation et IA · 6 min
Gemini 4 à 2 dollars est une publicité, pas un prix : budgétez vos outils d’IA au tarif qu’ils auront dans six mois
Équipe et organisation · 6 min
Le téléphone de votre direction ne devrait afficher aucune publicité : une simple pub vient d’infecter des journalistes d’Al Jazeera sans un clic