497 000 tokens, puis 121 000
Chez Balyasny, un fonds d’investissement new-yorkais, une seule réponse de l’assistant maison consommait en moyenne 497 000 tokens avec Claude Sonnet 5. Avec Sonnet 5.5, sorti par Anthropic le lundi 28 septembre 2026, la même réponse en consomme 121 000. Quatre fois moins de texte facturé, pour le même travail.
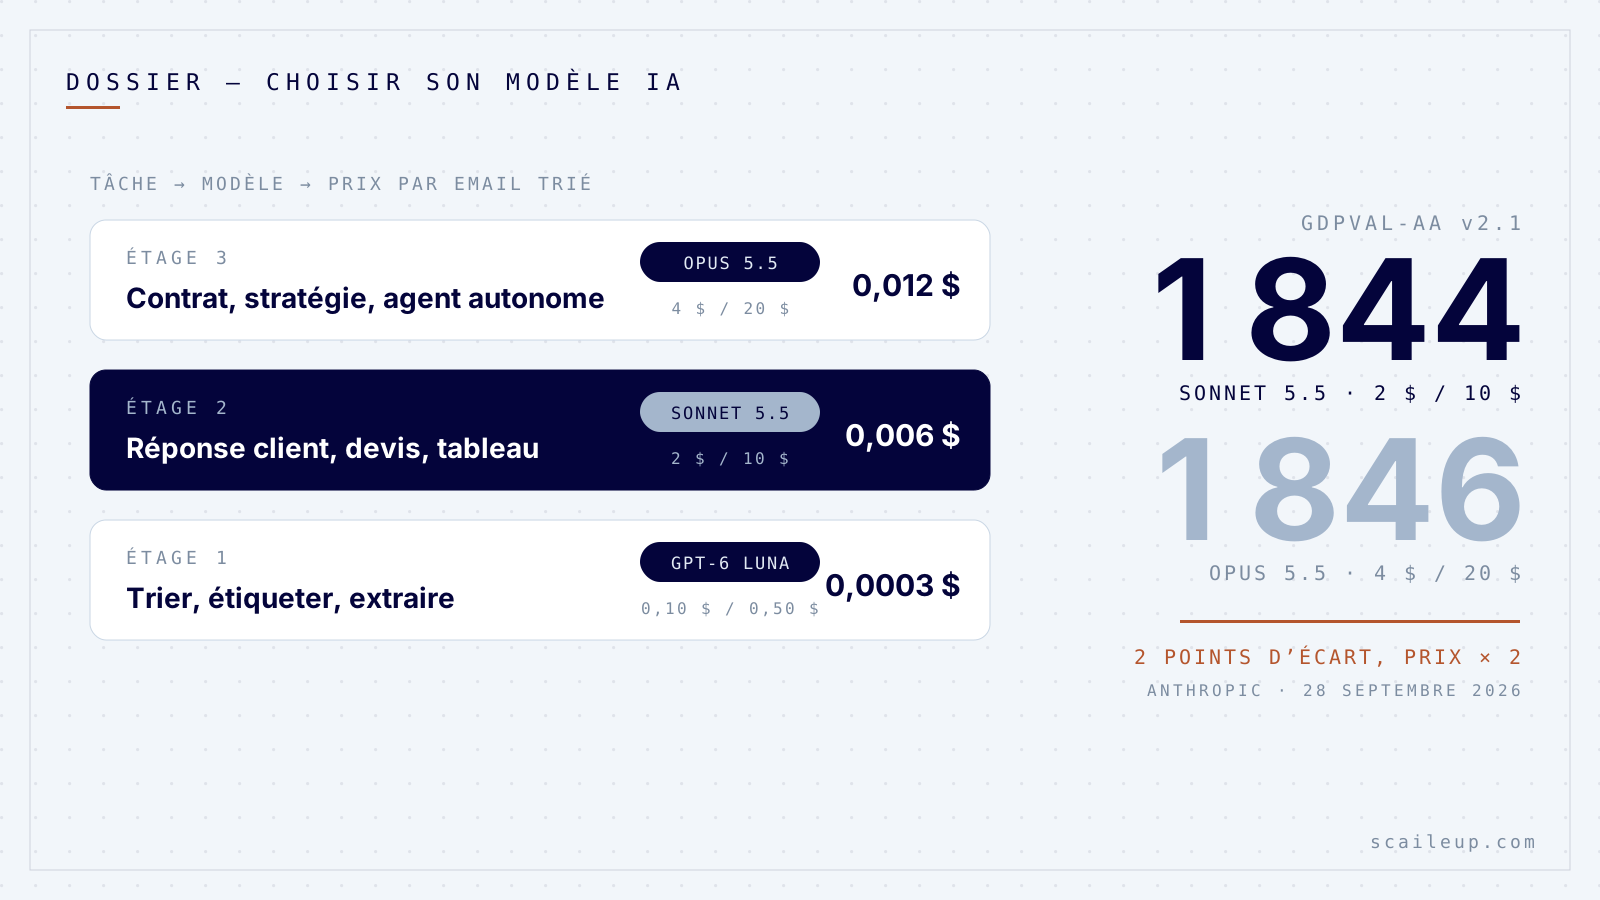
L’annonce a fait 693 points et 459 commentaires sur Hacker News dans la journée, reprise par TechCrunch, 9to5Mac et Thurrott. Le chiffre qui m’intéresse n’est pas celui de la vitesse. C’est celui-ci : sur GDPval-AA, un test fait de vraies tâches de bureau, Sonnet 5.5 obtient 1 844 points. Opus 5.5, le modèle haut de gamme de la même maison, en obtient 1 846. Deux points d’écart, pour un prix deux fois plus bas.
Ma thèse, et je sais qu’elle ne plaira pas à tout le monde : payer le modèle le plus cher pour vos tâches courantes, c’est jeter la moitié du budget. Le bon réflexe n’est plus de choisir « la meilleure IA », c’est de choisir un modèle par tâche.
Ce que l’annonce dit vraiment
Les prix publiés par Anthropic, en dollars par million de tokens (un token vaut environ trois quarts de mot) : Sonnet 5.5 coûte 2 $ en entrée et 10 $ en sortie, exactement comme Sonnet 5. Opus 5.5 coûte 4 $ et 20 $. Le texte relu depuis le cache descend à 0,20 $.
Sur les scores, Sonnet 5.5 passe de 10,3 % à 70,6 % sur Terminal-Bench 4.0, un test de tâches en ligne de commande, et dépasse même Opus 5.5 (66,4 %). Sur CursorBench 4.0, qui mesure le travail de développement, il reste un peu derrière : 55,5 % contre 57,8 %. Anthropic annonce des réponses 30 % plus rapides et un coût par tâche jusqu’à 30 % plus bas que Sonnet 5, parce que le modèle écrit moins pour arriver au même résultat. Box, l’éditeur de stockage en ligne, mesure 2,4 fois plus vite avec 12 % de tokens en moins.
Anthropic le dit elle-même : Sonnet 5.5 est fait pour les tâches bien cadrées du quotidien, corriger un bug, produire un document, un tableau, une présentation. Opus 5.5 reste le modèle des travaux qui demandent un jugement fin. C’est l’éditeur qui vous conseille de ne pas acheter son produit le plus cher pour tout. Ça mérite qu’on l’écoute.
Le calcul, avec une tâche que vous connaissez
Prenons un tri d’emails automatique : 200 messages par jour ouvré, 22 jours par mois, soit 4 400 messages. Chaque message envoyé au modèle pèse environ 1 500 tokens avec la consigne, et la réponse, une catégorie et un brouillon court, environ 300 tokens.
Avec Opus 5.5 : 1 500 × 4 $ plus 300 × 20 $ par million, soit 0,012 $ par message, 52,80 $ par mois. Avec Sonnet 5.5 : 0,006 $ par message, 26,40 $ par mois. Avec GPT-6 Luna d’OpenAI, affiché à 0,10 $ et 0,50 $ depuis le 22 septembre : 0,0003 $ par message, 1,32 $ par mois.
Pour trier un email en « devis », « facture », « à lire plus tard », le modèle le plus cher ne fait pas mieux que le moins cher de manière mesurable. Il coûte quarante fois plus. Sur un an, l’écart entre Opus et Luna pour ce seul flux dépasse 600 $. Ce n’est pas une fortune, mais multipliez par les cinq ou six automatisations qu’une PME finit par faire tourner.
La grille à copier : quel modèle pour quelle tâche
Voici la grille que j’applique. Trois étages, un critère : combien coûte une erreur.
- Étage 1, le modèle léger (GPT-6 Luna, Claude Haiku) : trier, étiqueter, extraire un montant d’une facture, résumer un compte rendu. Une erreur se voit tout de suite et coûte quelques secondes.
- Étage 2, le modèle intermédiaire (Sonnet 5.5, GPT-6 Sol à 2 $ et 10 $) : rédiger une réponse client, un devis à partir d’une bibliothèque de prix, un tableau, une présentation. Une erreur coûte une relecture.
- Étage 3, le haut de gamme (Opus 5.5) : un contrat à analyser, une stratégie tarifaire, un agent qui enchaîne vingt actions seul. Une erreur coûte un client ou de l’argent.
- Règle de passage : on commence toujours à l’étage le plus bas, et on ne monte que si dix essais sur un vrai cas montrent une différence que vous voyez à l’œil nu.
Où la bascule se fait, concrètement
Si vous passez par l’API, le changement tient en une ligne : le nom du modèle dans votre appel. Dans Make, dont l’offre Core démarre à 9 € par mois, c’est un menu déroulant dans le module Anthropic ou OpenAI. Dans n8n, même chose, dans le nœud du modèle. Je conseille de nommer chaque scénario avec son étage, « tri-emails-étage-1 », pour que la personne qui reprendra le système sache pourquoi ce choix a été fait.
Si vous utilisez l’application Claude ou ChatGPT par abonnement, le prix ne change pas selon le modèle, mais le temps de réponse, si. Anthropic règle d’ailleurs Sonnet 5.5 sur un effort « moyen » par défaut dans ses applications, et sur « élevé » dans l’API. Pour une reformulation de mail, l’effort moyen suffit largement.
Ce que je ne sais pas
Les scores cités sont publiés par Anthropic le jour du lancement, pas encore par un laboratoire indépendant. Les gains de Balyasny et de Box sont les leurs, sur leurs tâches ; les vôtres seront différents. Et mon calcul sur les emails repose sur des tailles de message moyennes : un fil de vingt réponses coûte davantage. Refaites-le avec vos chiffres, c’est l’intérêt.
Je ne dis pas non plus qu’Opus 5.5 est inutile. Sur un agent qui prend des décisions seul, deux points d’écart sur un test peuvent peser lourd sur le terrain. Le problème n’est pas le modèle cher, c’est le modèle cher par défaut.
Le geste de lundi matin
Ouvrez la liste de vos automatisations ou de vos usages quotidiens de l’IA, et notez à côté de chacun l’étage de la grille. Prenez celui qui tourne le plus souvent sur un modèle haut de gamme, faites-le passer à l’étage du dessous, et comparez dix résultats avant et après.
Et si vous voulez qu’on fasse ce tri avec vous sur vos outils, c’est l’objet de notre service : automatisation des processus.
Ce sujet vous concerne directement ?
30 minutes d'audit gratuit pour voir ce que ça donnerait dans votre entreprise, chiffres à l'appui.
À lire ensuite
Automatisation et IA · 6 min
Samsung a éteint des frigos à distance avec une mise à jour : la panne qui vous menace n’est pas le piratage
Automatisation et IA · 7 min
Un agent IA ne s’arrête pas devant « accès refusé » : OpenAI vient de le prouver en Australie, et le vôtre fera pareil
Développement commercial · 6 min
Votre position sur Google compte moins que la phrase que l’IA écrit au-dessus de vous : lisez-la avant de payer pour remonter