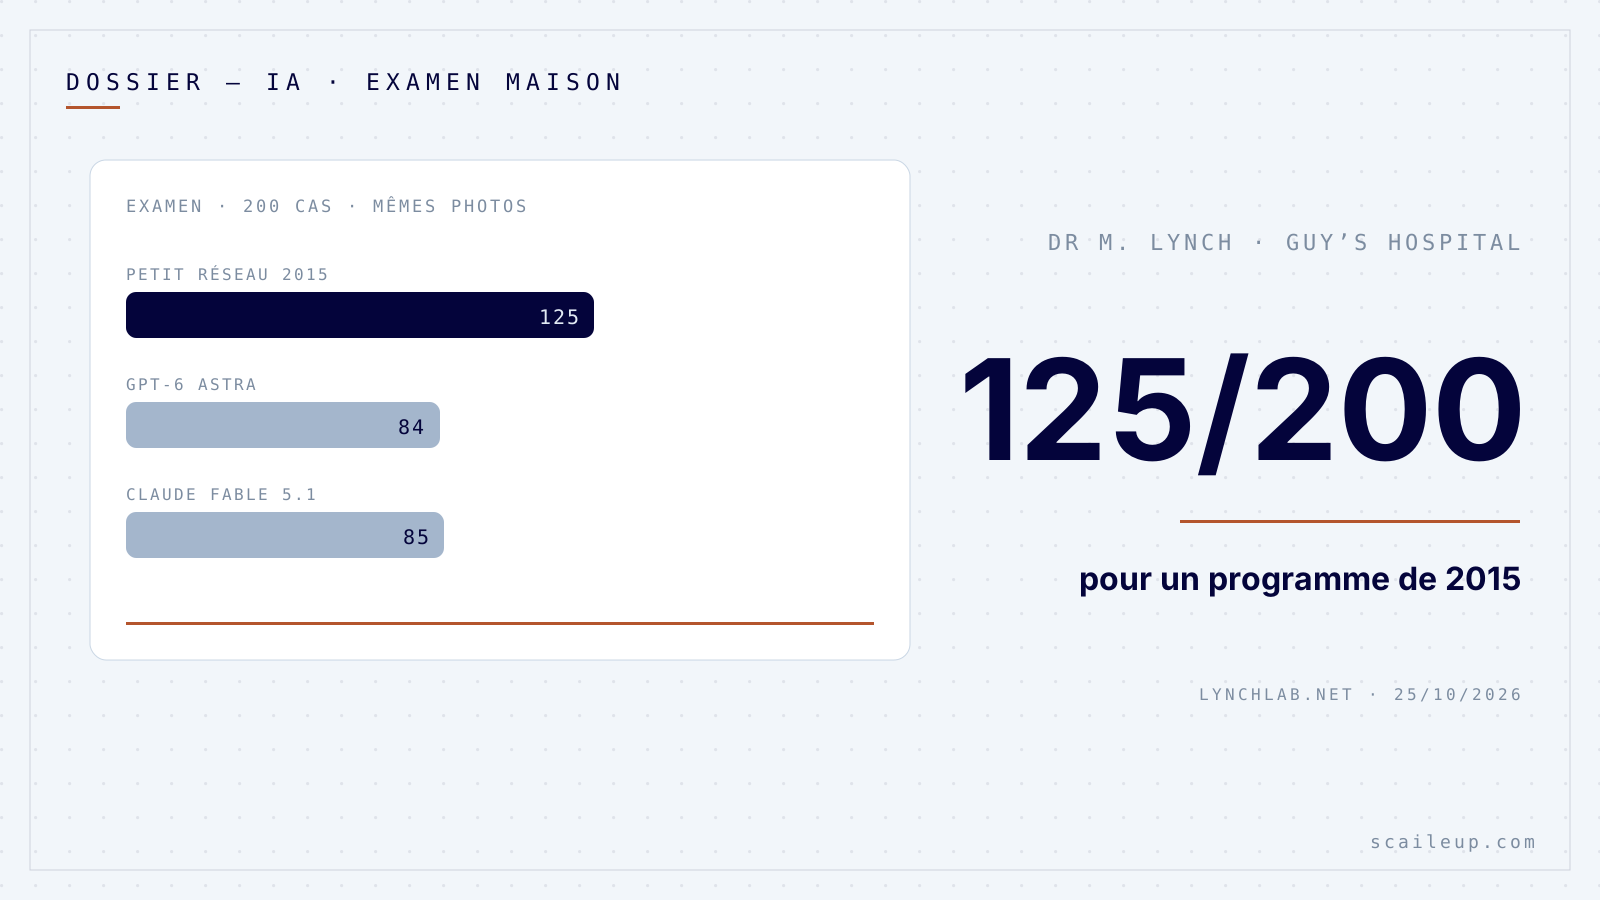
125 bonnes réponses sur 200 pour un programme de 2015, 84 et 85 pour deux IA de pointe
Le 25 octobre 2026, le Dr Magnus Lynch, dermatologue au Guy’s Hospital de Londres, publie sur son site un test simple. Au départ, deux IA de conversation utilisées telles quelles, sans réglage : GPT-6 Astra et Claude Fable 5.1. En face, Inception v3, un réseau de neurones publié par Google en 2015, que le médecin a réentraîné pendant environ vingt minutes sur une seule carte graphique H100, avec 68 011 images. L’examen : 200 lésions de peau toutes confirmées par biopsie, six diagnostics possibles.
Résultat au premier choix : 125 bonnes réponses sur 200 pour le vieux programme, 84 pour GPT-6 Astra, 85 pour Claude Fable 5.1. Sur les 30 mélanomes, 13 reconnus, contre 8 et 11. L’histoire a fait 511 points et 228 commentaires sur Hacker News le jour même. Source : lynchlab.net, 25 octobre 2026.
Je ne suis pas médecin, et cet article ne dit rien de ce qu’il faut faire d’un grain de beauté. Ce qui m’intéresse, c’est ce que ce résultat dit de la façon dont une entreprise achète de l’IA. Ma thèse, et vous pouvez la contester : pour une tâche qui revient des dizaines de fois par semaine, la bonne question n’est pas « quel est le meilleur modèle ? » mais « quel outil a déjà vu des cas comme les miens ? ».
Pourquoi le généraliste perd sur un cas précis
Un chatbot a lu un peu de tout, y compris un peu de dermatologie. Le petit réseau, lui, n’a vu que des peaux, 68 011 fois, avec la bonne réponse à côté. Ce n’est pas une question d’intelligence mais d’entraînement sur la tâche exacte. Vos factures, vos tickets, vos photos de pièces, vos e-mails de réclamation ont leur propre style, et un modèle qui en a vu des milliers avec l’étiquette correcte finit par les reconnaître mieux qu’un modèle brillant qui les découvre.
L’auteur donne lui-même les limites. Deux cents lésions seulement, dont 30 mélanomes, donc une marge d’incertitude importante. Chaque IA n’a été testée qu’une fois, et ses réponses peuvent varier. Le jeu de test est public depuis 2025, donc les deux chatbots l’ont peut-être croisé pendant leur entraînement, ce qui jouerait en leur faveur. Inception v3 est un modèle de référence, pas le meilleur du marché. Enfin, il précise avoir utilisé Claude Code pour l’analyse, et l’un des deux chatbots testés vient du même éditeur.
Le détail qui retourne le résultat : le seuil de décision
Le tableau de l’étude contient une ligne que le titre ne montre pas. Avec son réglage d’origine, le petit programme renvoie chez eux 18 mélanomes sur 30, contre 3 pour GPT-6 Astra et 4 pour Claude Fable 5.1. Les chatbots, eux, conseillent de consulter dans presque tous les cas, même pour des lésions bénignes : 97 et 96 lésions à risque conservées sur 100, mais aussi 68 et 78 lésions sans danger gardées sur 100. Quand le réglage du petit programme est aligné sur le leur, il ne renvoie plus que 2 ou 1 mélanome sur 30, selon l’auteur.
Traduisez en entreprise. Le meilleur taux de bonnes réponses ne dit pas ce que coûte chaque erreur. Une facture classée dans le mauvais compte se corrige en trente secondes. Une facture frauduleuse validée se paie. Un chatbot prudent qui renvoie tout à un humain ne vous fait rien gagner, et un outil spécialisé qui tranche tout seul vous fait gagner du temps jusqu’au jour où il se trompe du mauvais côté. Avant de comparer deux outils, écrivez quelle erreur vous coûte le plus cher, et réglez le seuil sur celle-là.
Ce que ça coûte, avec les chiffres publiés
Le réentraînement du médecin a duré environ vingt minutes sur une carte H100. Les comparateurs de location de cartes graphiques relevaient en août 2026 environ 2 dollars de l’heure chez RunPod en offre communautaire (computeprices.com), soit un peu moins d’un dollar pour l’entraînement. L’auteur ne donne aucun coût, c’est mon calcul. Le vrai coût est ailleurs : les 68 011 images étiquetées existaient déjà dans une archive publique. Chez vous, l’équivalent, ce sont les cas que quelqu’un de l’équipe a déjà traités et dont la bonne réponse est écrite quelque part.
Le chatbot, lui, se paie au volume. Claude Sonnet 5.5 est affiché à 2 dollars par million de tokens en entrée et 10 en sortie, contre 4 et 20 pour Claude Opus 5.5 (Anthropic, 28 septembre 2026). Et le PDG d’IBM, Arvind Krishna, disait le 22 octobre 2026 à ses investisseurs, selon The Register, que les modèles ouverts coûtent entre 10 % et 25 % du prix par token des modèles de pointe pour environ 90 % de leur efficacité sur la majorité des tâches courantes. Il vend du matériel, gardez ce point en tête.
Pour essayer sans écrire de code, deux pistes que je n’ai pas testées sur vos données. Teachable Machine, le site de Google, entraîne un classeur d’images dans le navigateur, et je l’ai toujours vu en accès libre. Roboflow propose de l’entraînement guidé : un relevé d’octobre 2026 donne un plan à 39 dollars par mois, mais les sources divergent sur les prix, vérifiez sur roboflow.com/pricing avant de compter dessus.
Le test maison de 300 cas, à copier
C’est la version de bureau de l’étude du Dr Lynch. Comptez une demi-journée la première fois :
- Choisissez une tâche de classement qui revient au moins cinquante fois par semaine : type de facture, motif d’une réclamation, état d’une pièce sur photo, service à qui router un e-mail.
- Réunissez 300 cas déjà traités par quelqu’un de l’équipe, avec la bonne réponse. Mettez 100 de côté dans un dossier nommé « examen » et n’y touchez plus : ils ne servent qu’à noter.
- Donnez ces 100 cas à un chatbot, avec la liste des réponses possibles, sans exemple. Comptez les bonnes réponses.
- Entraînez un petit outil sur les 200 autres, puis passez-lui les mêmes 100 cas. Comptez de nouveau.
- Dans une troisième colonne, comptez les erreurs graves, celles qui coûtent de l’argent ou un client. C’est cette colonne qui décide, pas la première.
Ce que vous pouvez faire lundi
Une seule chose : ouvrez votre boîte de réception ou votre dossier de factures, prenez la tâche de tri que votre équipe répète le plus, et copiez 100 cas déjà résolus dans un dossier « examen », avec la bonne réponse écrite à côté. Sans ce dossier, aucun outil ne peut être comparé à un autre, et vous achèterez sur la réputation.
Chez Scaile Up, je monte ce test avec vos propres cas avant de vous vendre quoi que ce soit, et vous gardez le dossier d’examen pour juger la suite.
Ce sujet vous concerne directement ?
30 minutes d'audit gratuit pour voir ce que ça donnerait dans votre entreprise, chiffres à l'appui.
À lire ensuite
Automatisation et IA · 6 min
Les consignes de votre chatbot finiront sous les yeux de vos clients : WhatsApp vient de se faire prendre avec 102 notes cachées
Automatisation et IA · 6 min
Le classement des IA ne dit rien de votre métier : 90 % des heures de travail ne sont testées par aucun examen
Gestion et finances · 6 min
Contre l’usurpation d’identité, un contrôle de dix minutes par an protège mieux qu’une assurance : Amanda Smith a fait trois nuits de prison faute de preuve